小红书上卖 99 的《毛选》知识库,制作过程非常简单,上班摸鱼的时间就搞定,后续还不需要维护,工具成本也接近 0。
开始之前,咱们需要准备3样东西:
1、任意 Agent,没订阅的朋友,WorkBuddy 免费积分和新出的豆包工作试用也能完成。
2、腾讯的 IMA 知识库 https://ima.qq.com/ 。
3、小红书千帆 (没有店铺的快去申请,现在是小红书引流时期,开店比较简单,但是口子会越收越紧)。
补充:发布前又确认了一下,开店现在还是 0 元入驻,但是电子资料类产品比我之前多了个 1000 粉准入,但是不要灰心,还有爱发电、知识星球、小报童等等平台,小红书继续发相关笔记做引流就好。
这套流程的本质,就是把 AI 加工后的原著内容上传到腾讯 IMA,然后作为数字产品交付。卖的不是那几份 PDF,而是已经整理好的内容使用入口,说白了,就是信息加工差。
第一步:原典处理
原典可以直接去 Zlibrary 下,链接我就不放了。
下好原典后,丢给 AI 告诉他按章节拆成 Markdown 文档
你是一名文献数字化编辑。

我要把当前目录中的整套原始资料,直接整理成适合 AI 知识库使用的 Markdown 文档。

目标:

一个独立章节 / 篇目 = 一个 Markdown 文件。

请执行:

1. 读取整套资料的目录。
2. 识别全部章节或篇目。
3. 按原始目录逐篇整理。
4. 文件名格式:

序号_篇名.md

例如:

01_实践论.md

5. 每篇只保留一个一级标题:

# 篇名

6. 正文保持原文自然段结构。
7. 不总结。
8. 不改写。
9. 不自行删减。
10. 不给原文增加 AI 解读。

如果原始资料是扫描 PDF:

先判断是否存在文本层。

如果没有文本层,可以使用 OCR。

如果我同时提供了数字文本源:

- 必须通过篇名匹配。
- 不能仅按照文件顺序匹配。
- 数字文本与当前版本目录不一致时,以当前版本为准。
- 所有无法确认的标题、缺字、标点和 OCR 错误单独列入待核对清单。
- 不允许根据常识自行补全文字。

完成后检查:

1. 原始目录篇目数量
2. 实际 Markdown 数量
3. 是否存在重复
4. 是否存在缺失
5. 是否存在空文件
6. 所有无法确定的内容

数量不一致时不要自行忽略,直接告诉我。
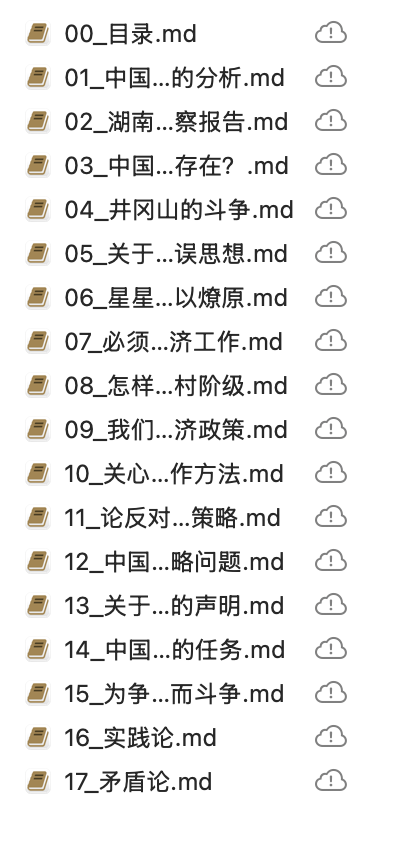
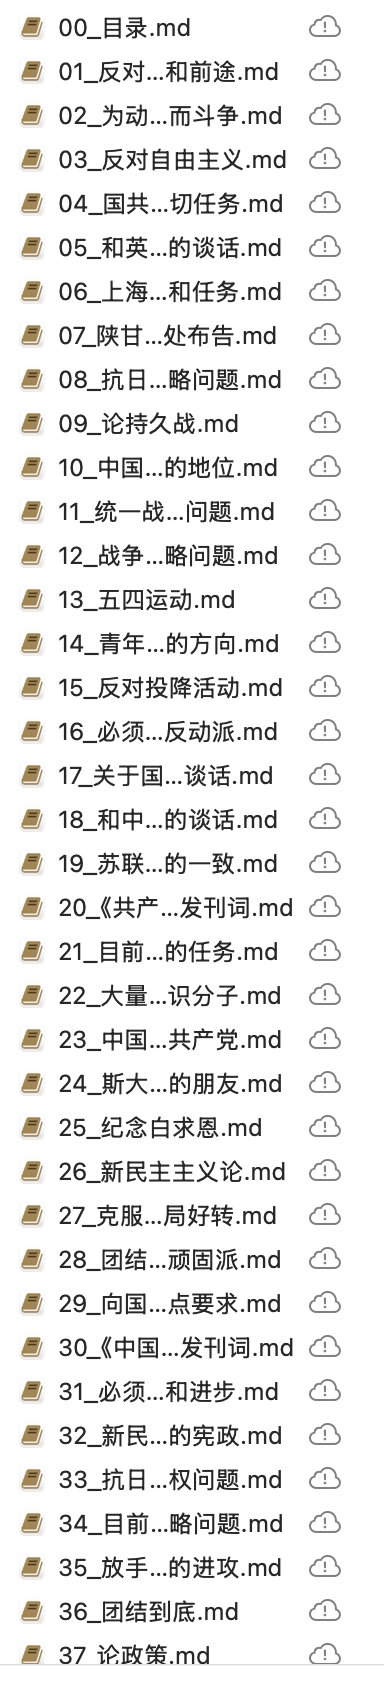
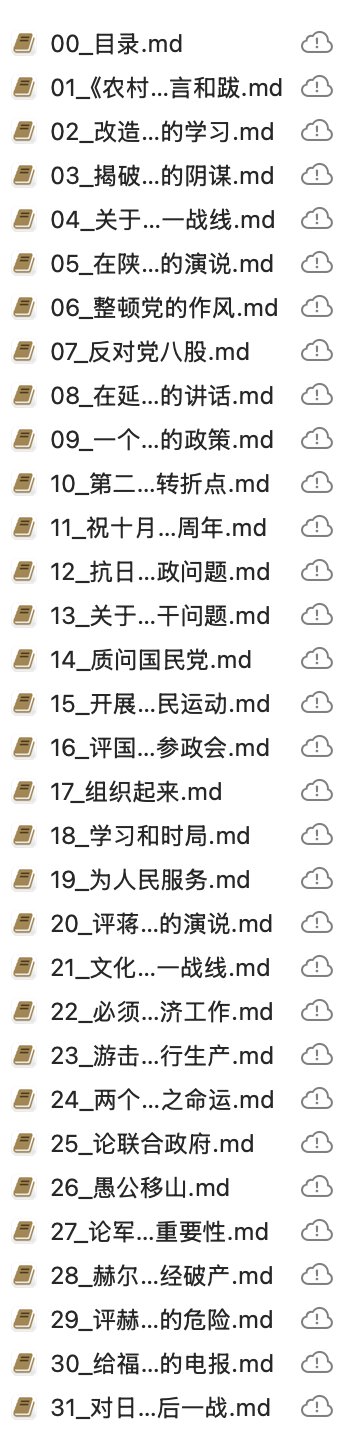
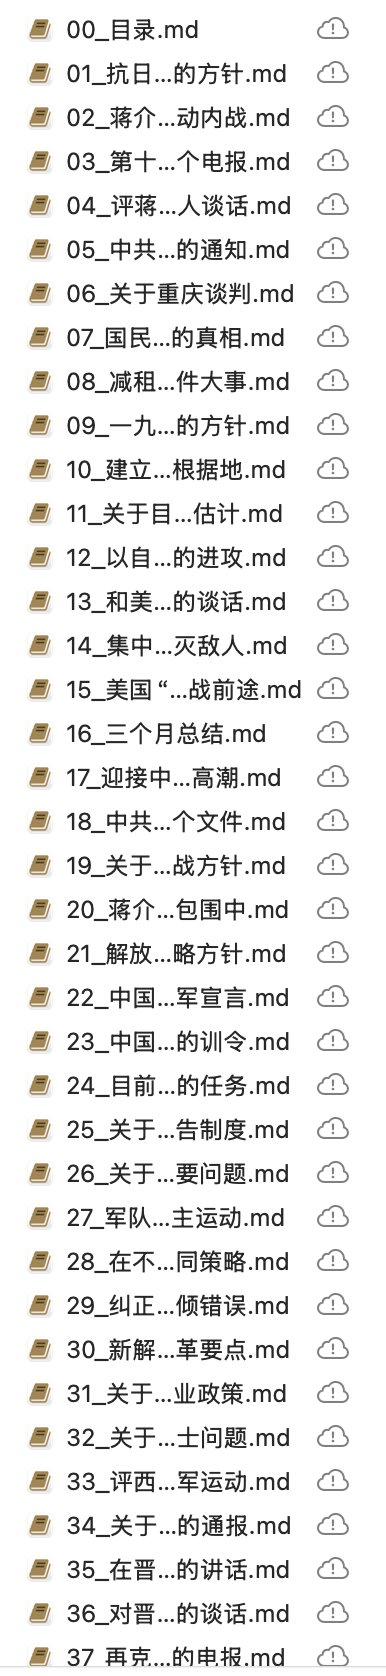
之后你会得到四份完整详细的原典单篇 Markdown 文档:
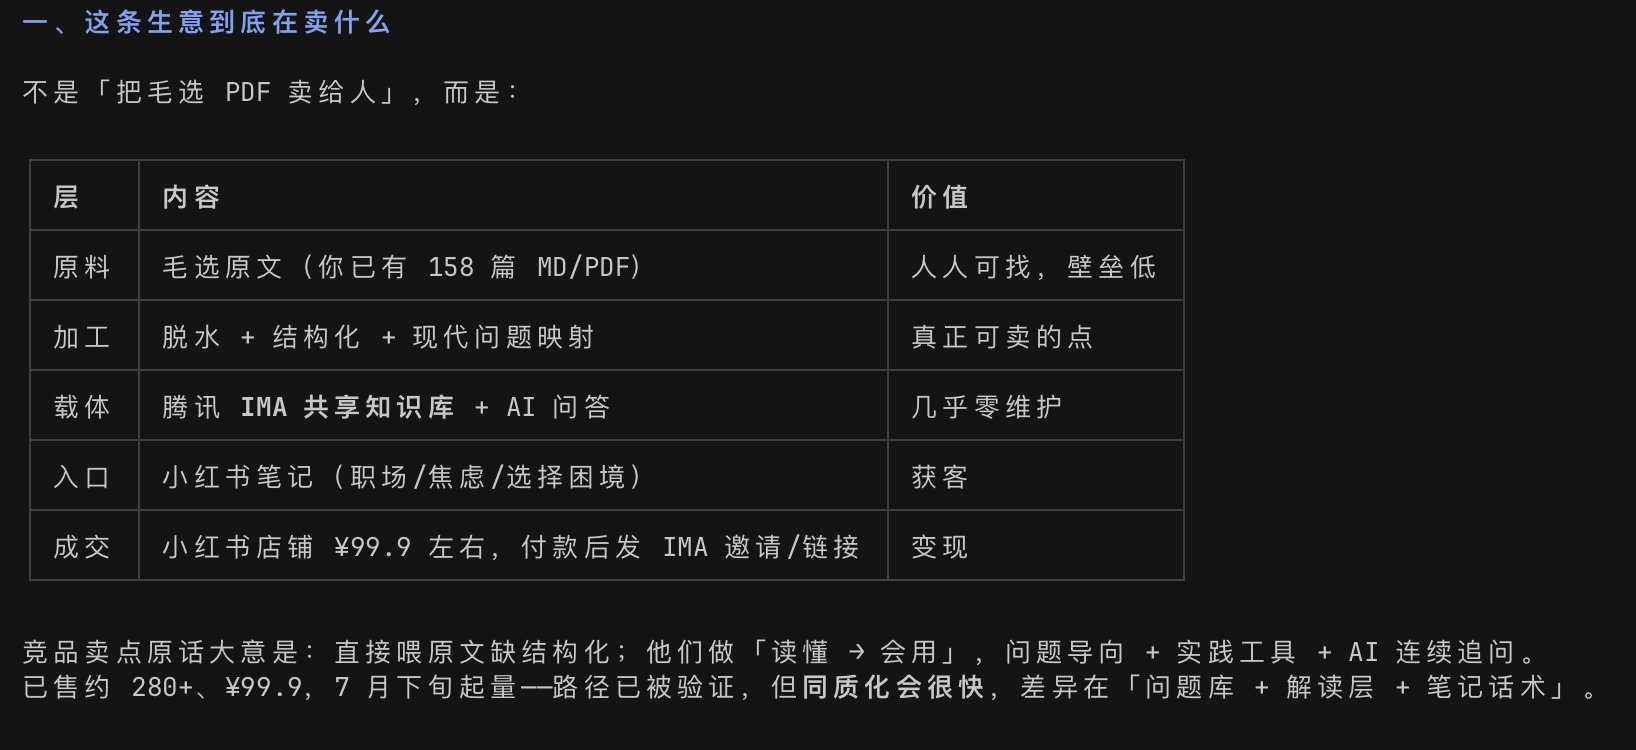
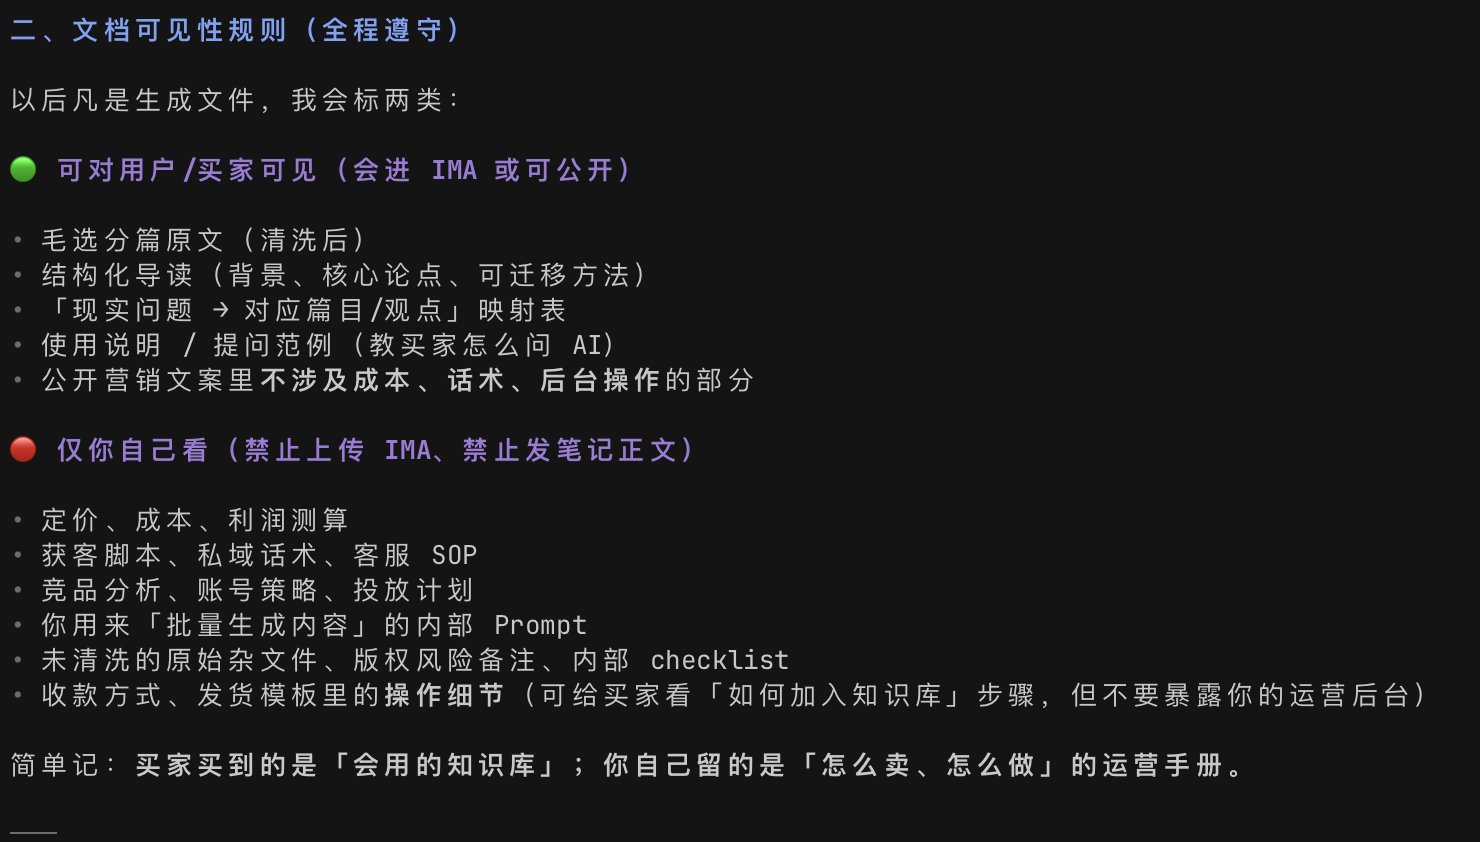
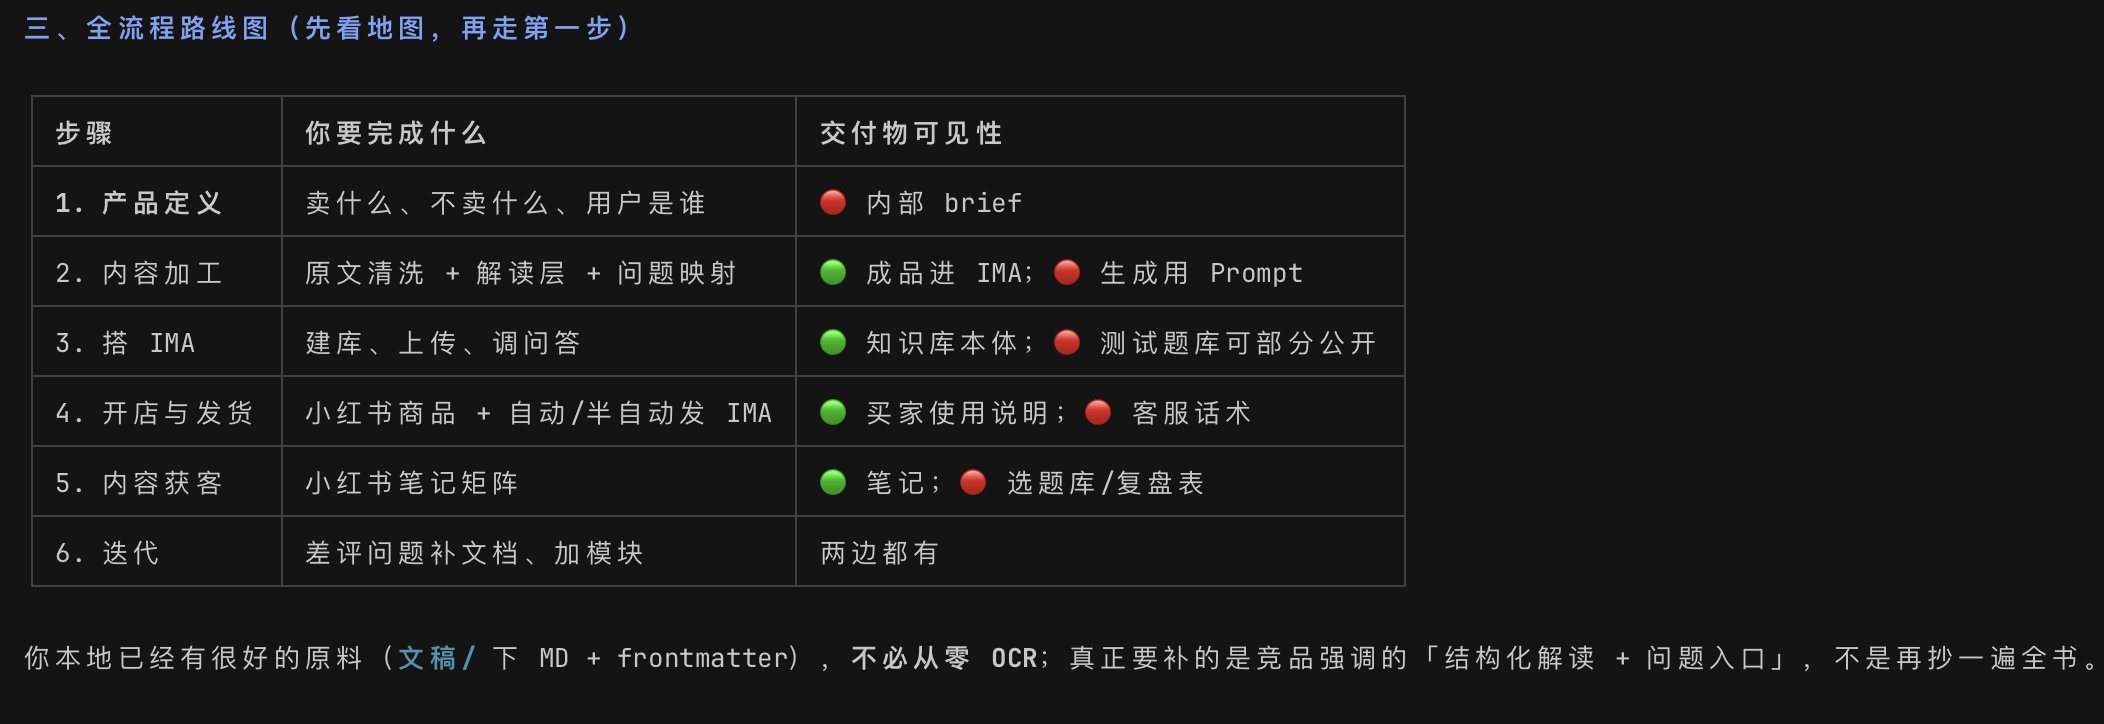
第二步:调研别人到底在卖什么
这个步骤对想做其他知识库的朋友非常重要(只想复刻本套《毛选》的朋友可以跳过)。
先调研同类产品,看用户到底在为什么付费、竞品除了原始资料还提供了哪些解读、工具和使用方式,再结合最近的真实问题,反推自己的知识库应该补什么。
核心不是“别人卖什么我就做什么”,而是先确认:用户为什么不直接把 PDF 扔给 AI。
你是一名数字知识产品研究员。

我要把【主题名称】制作成一个可以通过 AI 知识库交付的数字产品。

【可以多放几个你找到的店铺链接】

请结合参考链接及全网检索完成一次竞品和用户需求调研。

重点研究:

1. 同主题知识库
2. 同主题电子资料产品
3. 同主题课程
4. 同主题思维模型或工具产品
5. AI 知识库产品
6. 最近 30—90 天与这个主题相关的用户讨论和热点问题

每个竞品记录:

- 产品名称
- 平台
- 当前公开价格
- 产品定位
- 主要解决的问题
- 核心卖点
- 实际交付内容
- 是否包含 AI 问答
- 是否包含解读
- 是否包含案例
- 是否包含模板
- 是否包含思维工具
- 是否包含音频 / 播客
- 用户公开反馈中反复出现的问题
- 来源链接
- 查询日期

严格区分:

【事实】
页面能够直接证明的信息。

【判断】
你根据多个信息作出的产品分析。

要求:

- 不把搜索摘要当成已经核实的商品信息。
- 无法打开的页面标记【未验证】。
- 不虚构销量。
- 不虚构评价。
- 不复制竞品正文。
- 重点研究产品结构和真实需求。

然后根据调研结果告诉我:

1. 用户为什么愿意付费
2. 用户为什么不会直接自己上传 PDF
3. 这个产品必须包含哪些内容
4. 哪些属于提高价值感的附加内容
5. 最近有什么新的问题值得补充
6. 哪些竞品功能其实没必要做
7. 给出最终知识库内容架构

最后不要只给我一份竞品表。

我要的是:

根据市场反推出我应该生产什么。
完成后,AI 会告诉我们,一个可以卖钱的知识库都要具备哪些内容。
第三步:制作全量可上传内容
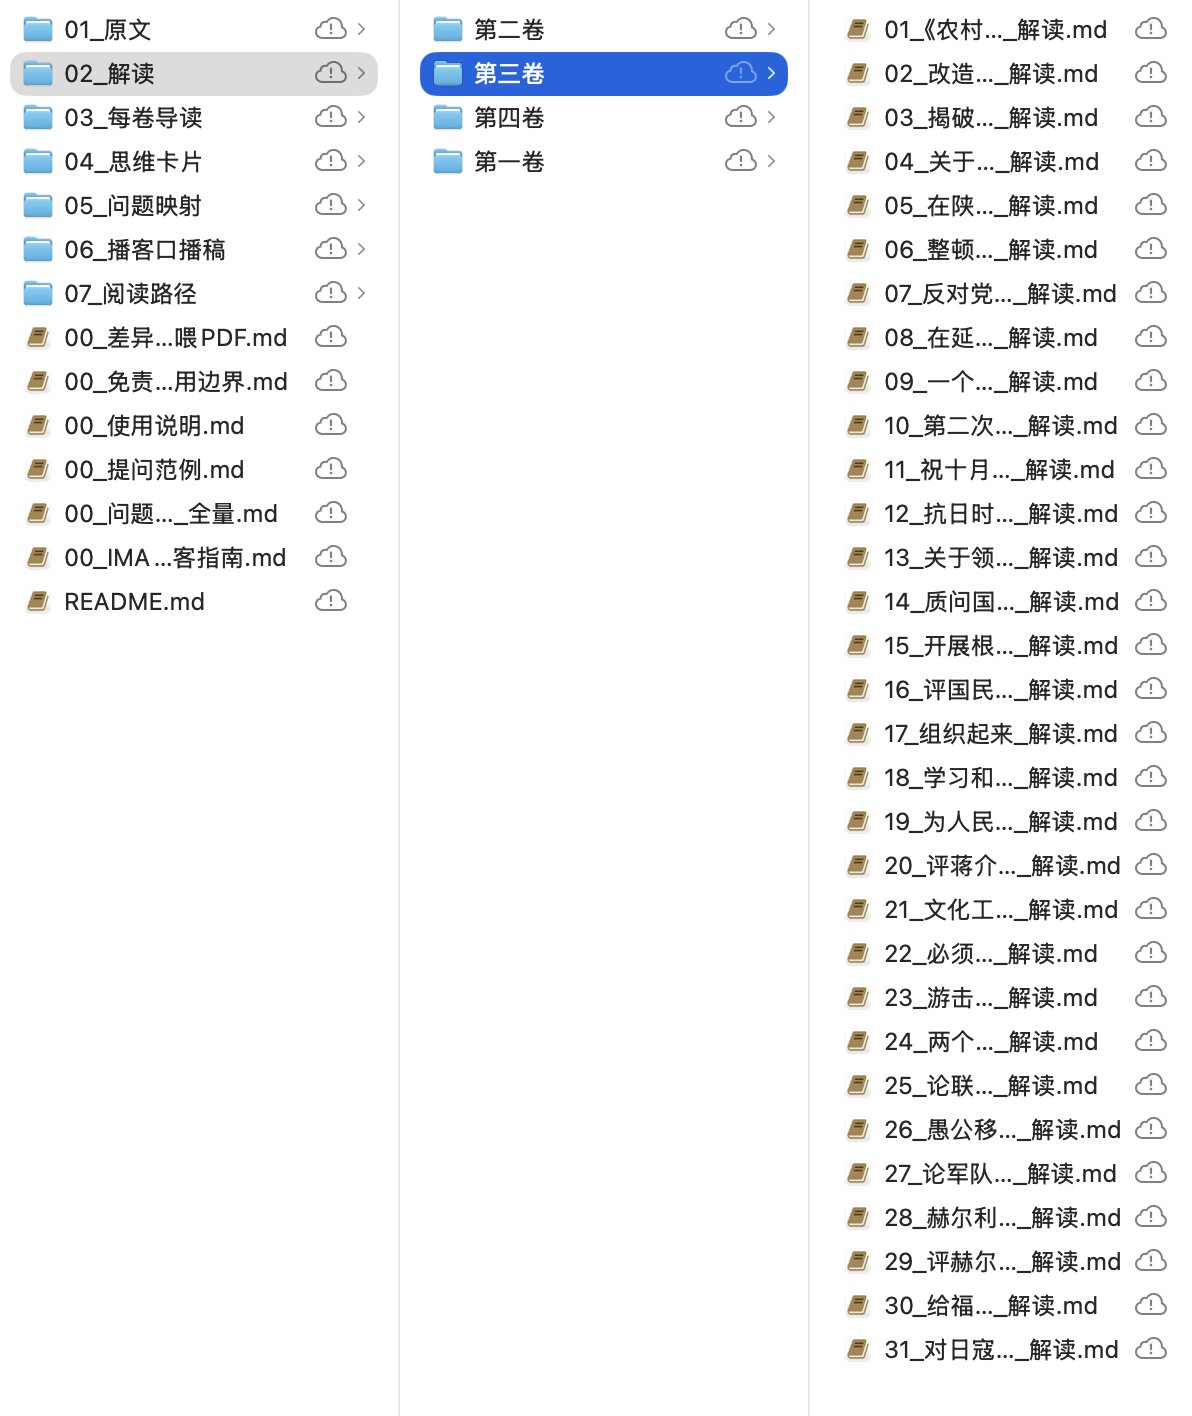
AI 会直接根据调研的结果,规划好上传内容的文件夹并制作所有上传内容。
你现在是一名 AI 知识产品总编辑。

当前目录中已经有:

1. 完整原典 Markdown
2. 竞品调研报告
3. 用户需求分析
4. 最近热点问题调研

现在请制作最终可以上传 AI 知识库的完整内容。

目标不是简单总结原文。

而是把原始资料加工成一个:

能读
能搜
能问
能理解
能解决实际问题

的知识库。

最终内容分为五层。

━━━━━━━━━━

第一层:原典

原典保持不变。

禁止:

- 改写
- 总结代替正文
- 偷偷修改表达
- 把现实解释加入原文

━━━━━━━━━━

第二层:结构化解读

为每一篇原文建立对应解读。

统一结构:

# 篇名|解读

## 为什么值得读

## 背景

## 它在解决什么问题

## 核心观点

## 关键概念

## 原文中的关键内容

## 今天可以怎样理解

## 延伸阅读

要求:

所有引用必须能在输入原文中找到。

历史事实必须有可靠来源。

明确区分:

- 原文观点
- 历史事实
- 编辑者的现实解释

不能把自己的解释伪装成作者原意。

没有合适现实案例时不要编案例。

━━━━━━━━━━

第三层:导航

根据全部内容制作:

- 从这里开始
- 知识库使用说明
- 每一部分导读
- 新手阅读路线
- 深度阅读路线
- 按问题寻找内容的索引
- 怎样向 AI 提问

目标:

第一次进入知识库的人,不需要先理解目录,就知道应该怎么用。

━━━━━━━━━━

第四层:实用工具

根据原典和竞品调研制作:

- 思维卡片
- 情景问题
- 行动清单
- 决策模板
- 可直接复制给 AI 的问题

每个工具必须能够追溯到具体原文或者已经完成的解读。

禁止为了凑数量发明方法。

━━━━━━━━━━

第五层:专题内容

根据最近 30—90 天的真实用户问题建立专题。

注意:

热点只是问题入口。

不要为了追热点修改原典。

每个专题说明:

1. 当前问题是什么
2. 为什么值得讨论
3. 知识库中哪些内容与它有关
4. 可以怎样理解
5. 可以采取什么行动

热点过期以后,删除专题不能影响整个知识库结构。

同时制作适合 AI 播客 / 音频总结使用的专题来源材料。

━━━━━━━━━━

最终输出必须是纯 Markdown。

不要在最终上传目录中包含:

- 提示词
- 制作日志
- 任务进度
- 内部审核表
- 销售话术
- 上架教程
- 临时备注

完成以后检查:

1. 最终目录树
2. 总文件数量
3. 每类文件数量
4. 原文与解读是否一一对应
5. 是否存在缺失
6. 是否存在重复
7. 是否存在无法核实的引用
8. 哪些文件建议人工重点检查

发现异常不要自己忽略。
最后你会得到一个包含所有上传内容的完整知识库文件夹,IMA 知识库就是根据这些内容回答用户,你也可以用这些内容制作带钩子的宣传物料。
第四步:做一轮国内发布审核
内容做完不要马上去卖,先单独开一次审核任务。这步不只是看看有没有敏感词。
至少要检查四件事:1、版权来源;2、事实和引用;3、现实延伸;4、AI 内容本身
你现在是一名中国大陆互联网数字内容发布审核编辑。

我要把当前知识库作为数字知识产品公开发布。

请对最终内容做一次完整审核。

注意:

这不是简单的敏感词扫描。

分别检查以下内容。

━━━━━━━━━━

一、版权与来源

检查:

- 是否包含来源无法确认的大段版权内容
- 是否复制现代出版社注释
- 是否复制他人的整理稿
- 是否使用未经确认授权的封面
- 是否使用未经确认授权的图片
- 是否使用未经确认授权的人物照片
- 是否出现“网上公开所以默认可以商业使用”的错误判断

无法判断权利状态的内容统一标记:

【需要人工确认】

不要替我直接得出法律结论。

━━━━━━━━━━

二、事实

检查:

- 原文引用是否真实存在
- 人名
- 时间
- 地点
- 历史事件
- 数据
- 来源

重点寻找:

AI 根据上下文自行补出的内容。

所有无法核实的内容标记:

【事实待核实】

━━━━━━━━━━

三、原文与解读边界

检查是否存在:

- 把编辑者理解写成原作者观点
- 把现代概念强行塞进原文
- 断章取义
- 为了现实应用改变原意

━━━━━━━━━━

四、现实延伸

检查:

- 是否把历史政治表达直接变成现实政治判断
- 是否煽动现实对立
- 是否把军事语言机械映射成职场斗争
- 是否出现教用户操控、攻击或者整治他人的表达

需要时改写成:

调查
判断
重点
资源
目标
反馈
合作
边界
风险
预案

等中性的方法表达。

━━━━━━━━━━

五、营销表达

检查并标记:

- 保证赚钱
- 保证升职
- 改变命运
- 治愈焦虑
- 最权威
- 全网最全
- 唯一
- 100%有效
- 无依据销量
- 虚构用户评价

━━━━━━━━━━

六、AI生成内容

指出:

哪些准备公开发布的内容属于 AI 生成或显著 AI 辅助内容。

提醒我按照当前平台提供的 AI 内容声明和标识功能发布。

━━━━━━━━━━

最终输出四类:

【可以直接使用】

【修改后使用】

【需要人工确认】

【建议删除】

每一项说明:

文件名
具体位置
问题
原因
建议修改方式

不要笼统告诉我“整体没有问题”。
输入提示词,并让 AI 完成修改即可。
第五步:传到 IMA,包装成一个真正的知识库
这步直接去 IMA 上传做好的内容即可。
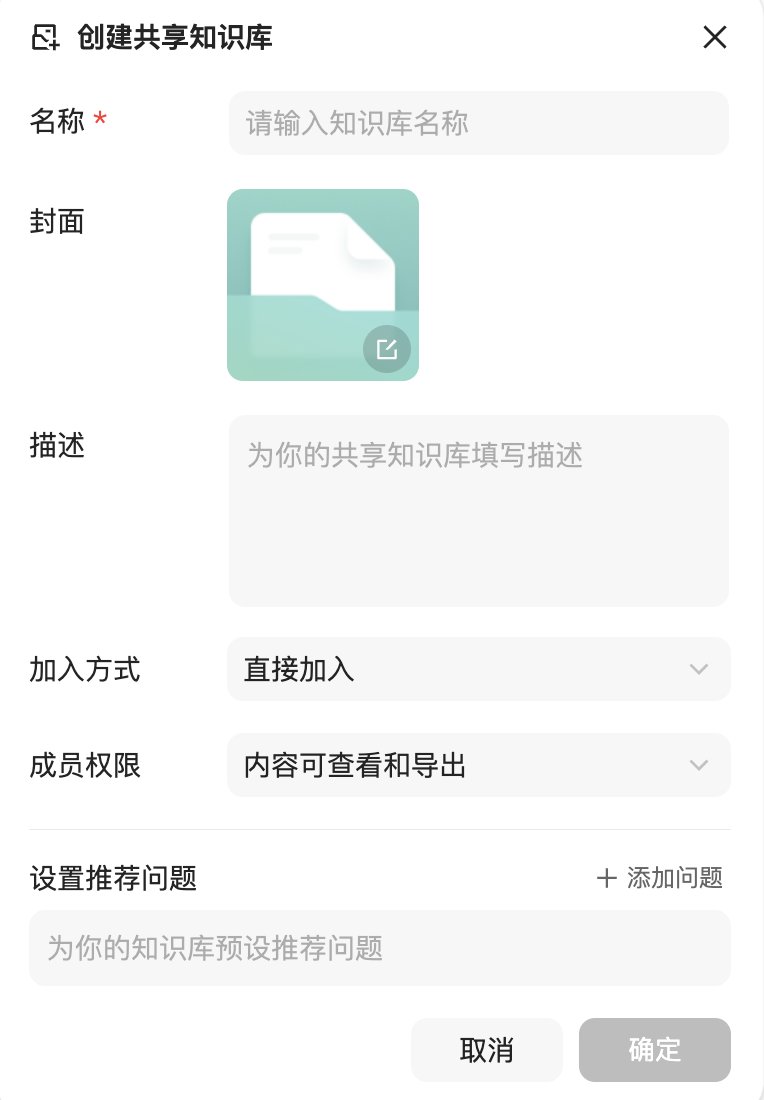
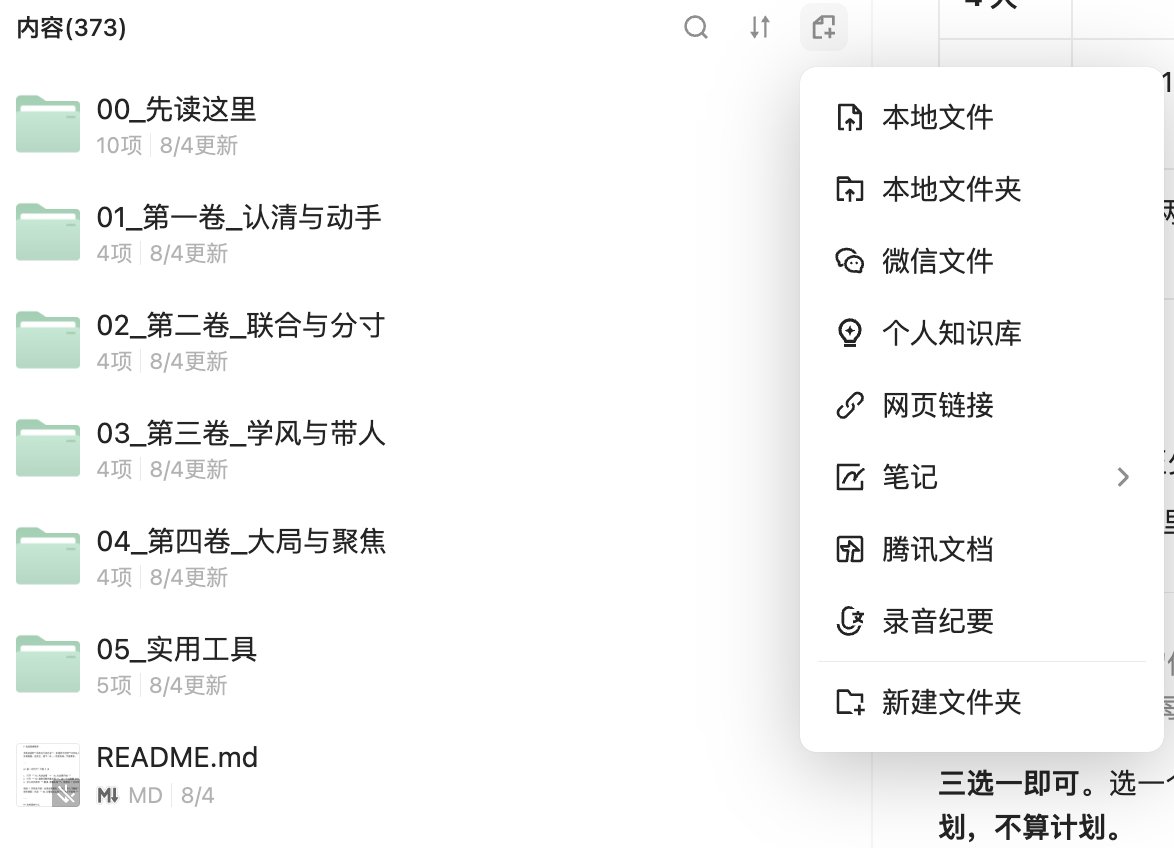
封面、描述、三个问题都是 AI 生成的,这里给个参考
设计一个 1:1 正方形 AI 知识库头像。

名称:
【名称】

主题:
【主题】

采用的视觉方向:
【刚刚选择的方向】

要求:

- 极简
- 清楚
- 有识别度
- 缩小到 64×64 像素仍然能识别主要图形
- 主体居中
- 不使用复杂背景
- 不堆砌文字
- 不做传统 AI 科技海报风
- 不使用未经授权的图片、书封、人物肖像或品牌 Logo

视觉应该像一个长期运营的知识产品,而不是一次性宣传海报。
请读取我准备上传的完整知识库目录和内容。

不要根据聊天记录猜。

为这个知识库写一份面向真实用户的知识库介绍。

必须回答四个问题:

1. 这个知识库是什么
2. 适合什么人
3. 可以用它解决哪些具体问题
4. 第一次打开应该怎么使用

要求:

- 只介绍最终知识库真实包含的内容。
- 文件数量必须真实统计。
- 不介绍制作过程。
- 不出现“卖家、产品制作、后台”等内部语言。
- 不保证赚钱、升职或者其他结果。
- 不使用“最全、最强、唯一、权威”等无法证明的词。
- 不像广告软文。
- 读起来像一个真正有用的知识库介绍。

输出三个版本:

A. 一句话定位

B. 80 字以内简介

C. 150—250 字完整介绍
读取整个知识库。

帮我设计三个显示在知识库首页的推荐问题。

目标:

第一次进入知识库的人,只看这三个问题,就能理解这个知识库可以怎样使用。

要求:

- 每个问题必须对应知识库真实存在的内容。
- 使用普通用户会说的话。
- 不要写成“请介绍知识库”。
- 不要考知识。
- 要从真实问题出发。
- 三个问题覆盖三种不同使用场景。
- 每个问题不超过 30 个汉字。

同时告诉我:

每个问题主要会命中哪些知识库内容。
完成后大概长这样:
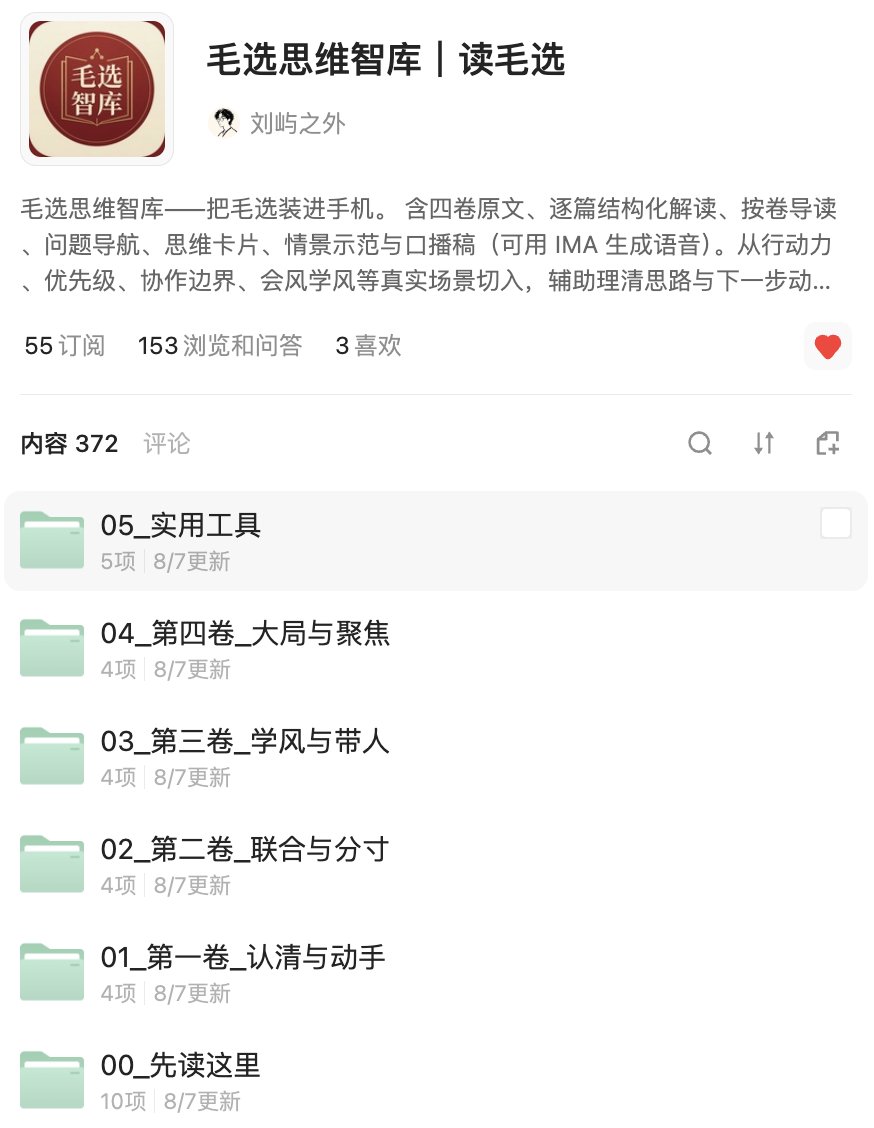
这时候就可以根据知识库内容,让 AI 找钩子做物料发笔挂店铺了。
最后,哪怕暂时不卖,这套流程也不算白折腾。
大长篇巨著、行业资料、工作文档等等,都可以照着做一遍。配合 obsidian 做出自己的积累还是有很大的变现想象空间。
我们缺的从来都不是资料,缺的是怎么把这些资料真正用起来。现在 AI 帮我们补上了。