诸位,这篇主要讲 Jev 接入 Grok Bot 的步骤,以及接完以后,该怎么用。
Jev 是 TypeSafe 专门用来做选择、打分、分类的轻量模型。它不会写长篇大论,也不擅长写代码,但做单选题和排序极快。
没有的朋友直接去下面这个链接申请就行,没什么门槛,等12小时差不多就通过了: https://typesafe.ai/
把 Jev 接进 Grok Bot,核心思路就是给你的 Bot 配了一个专门分类或初筛的外包助手。
第一部分:接入步骤
1、拿到 API Key
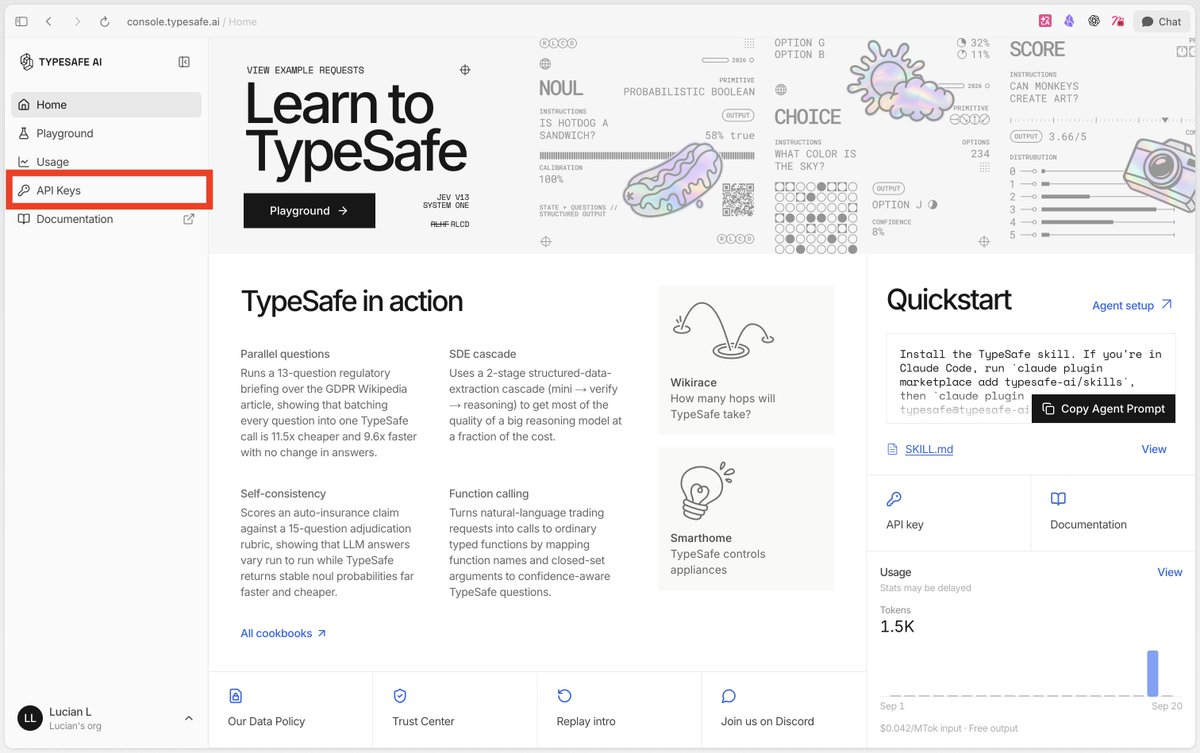
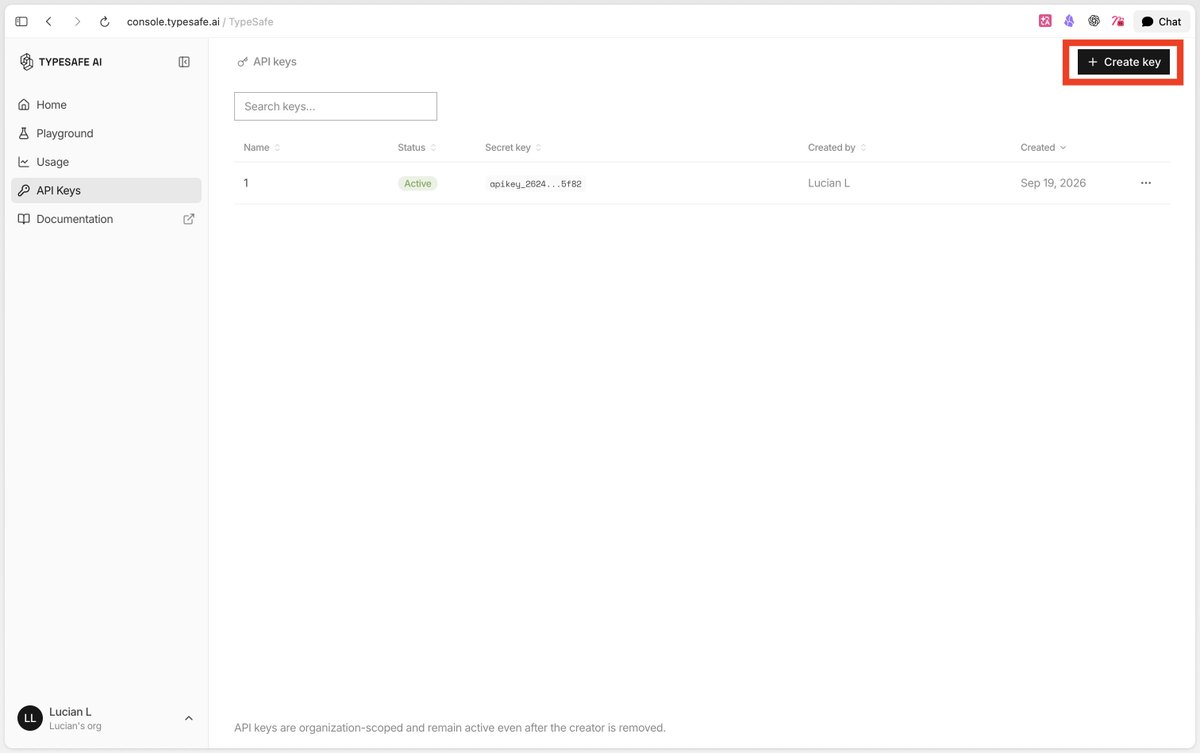
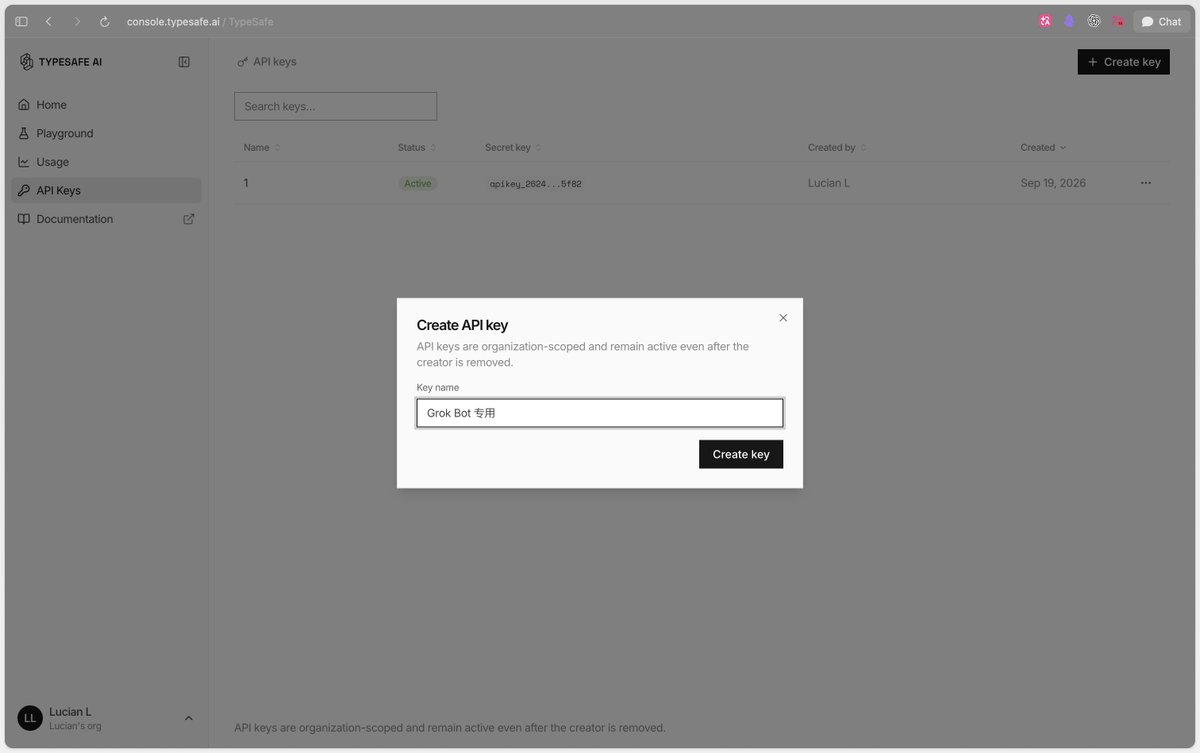
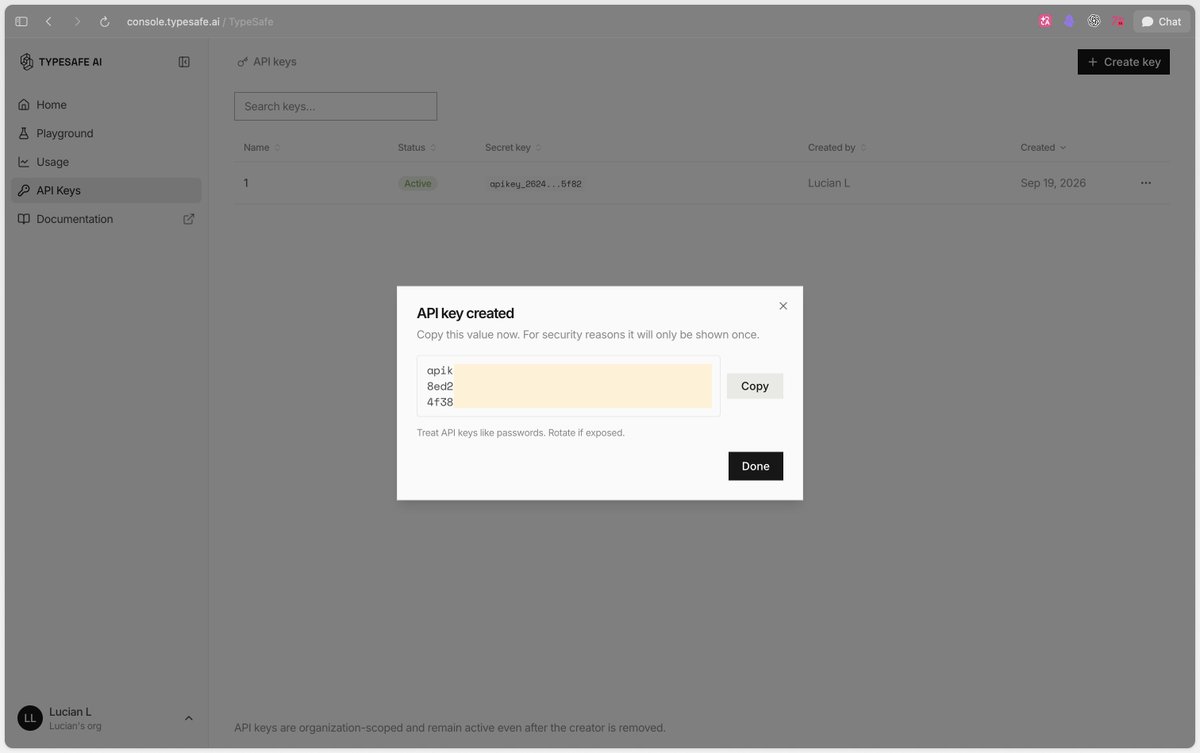
申请通过后,打开 TypeSafe 控制台,登录后获取 API Key。
注意:要先保存好你的 API Key ,再点Done,这串密钥只显示一次。
2、把 Key 存进 Grok Bot
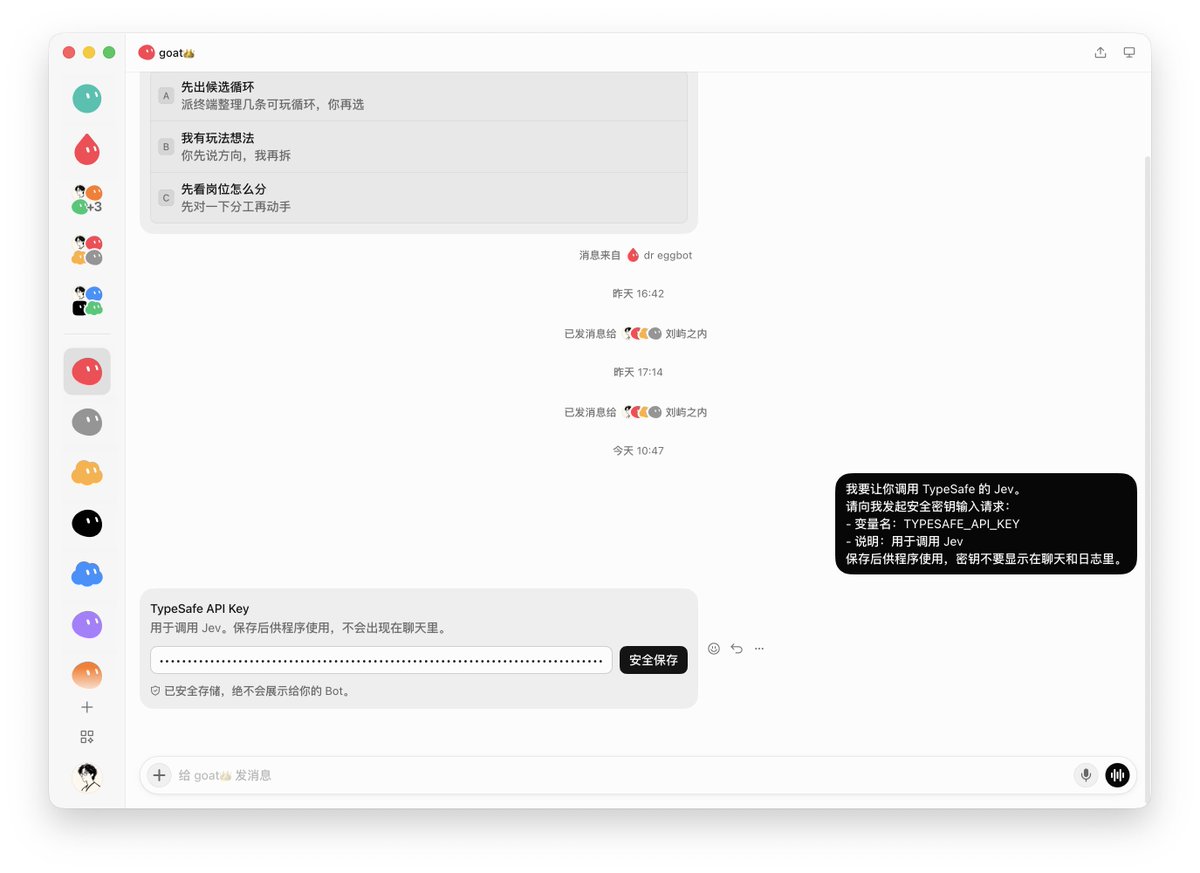
拿到 API Key 后,我们不要直接发到 Bot 的聊天里,要让 Bot 调用安全卡保存。
这里以是我的游戏策划 Bot 为例,在聊天框发给它:
我要让你调用 TypeSafe 的 Jev。
请向我发起安全密钥输入请求:
- 变量名:TYPESAFE_API_KEY
- 说明:用于调用 Jev
保存后供程序使用,密钥不要显示在聊天和日志里。

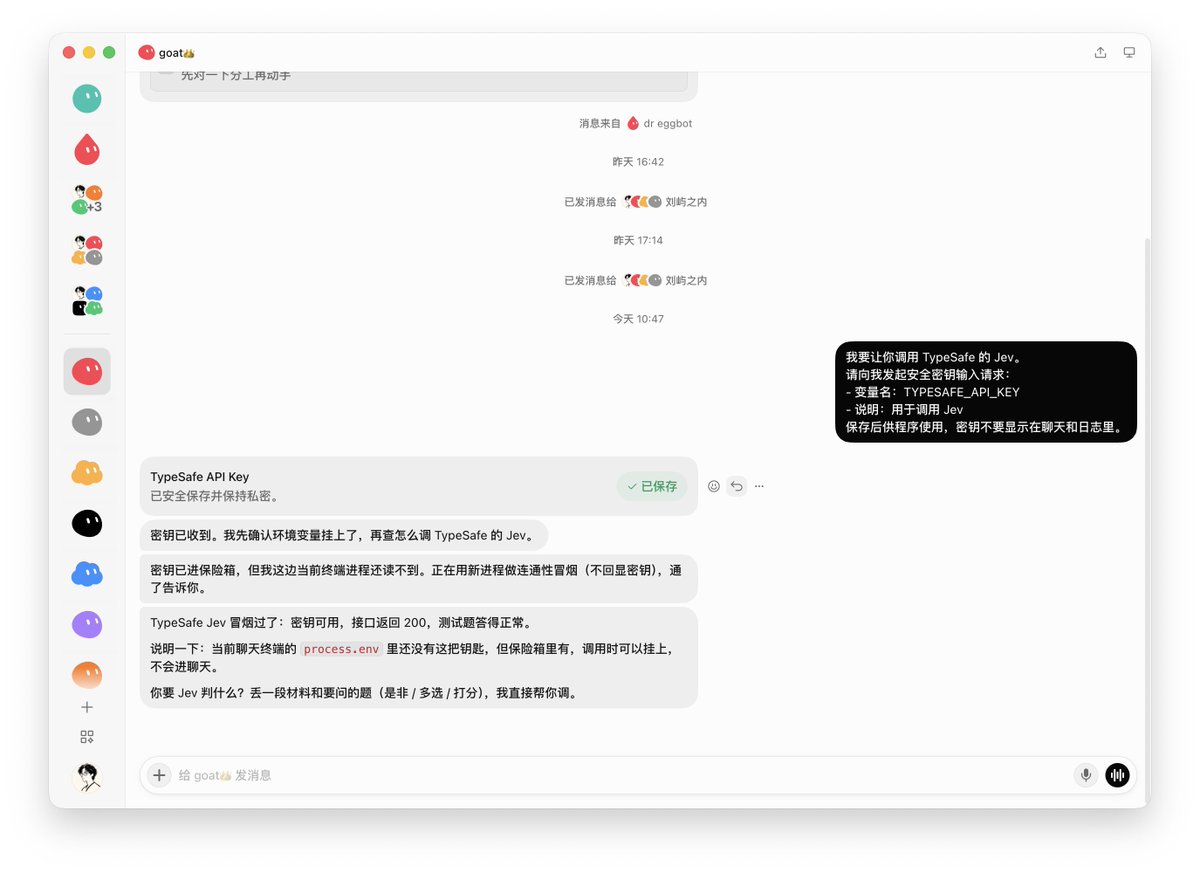
TypeSafe API Key
已安全保存并保持私密。
等 Bot 弹出安全输入卡片,粘贴进上一步复制的 API Key 即可。
3、安装调用工具并测试
密钥存好后,接着在 Bot 聊天框发送:
请阅读 https://docs.typesafe.ai/introduction/quickstart

在 /workspace/jev 用 Python≥3.10 独立虚拟环境安装 typesafe-sdk。写一个可重复调用的脚本/命令:输入「文字 + 问题 + 选项说明」,用 TypeSafeClient.system_one,模型 jev-latest,题型 Choice。


先真实调用一次:
文字:「游戏的开始按钮点了没反应」
问题:「这条反馈属于哪一类?」
选项:
- 程序故障:已有功能不能用
- 美术调整:画面和视觉
- 玩法建议:新增或改规则
- 信息不足:看不出属于哪类

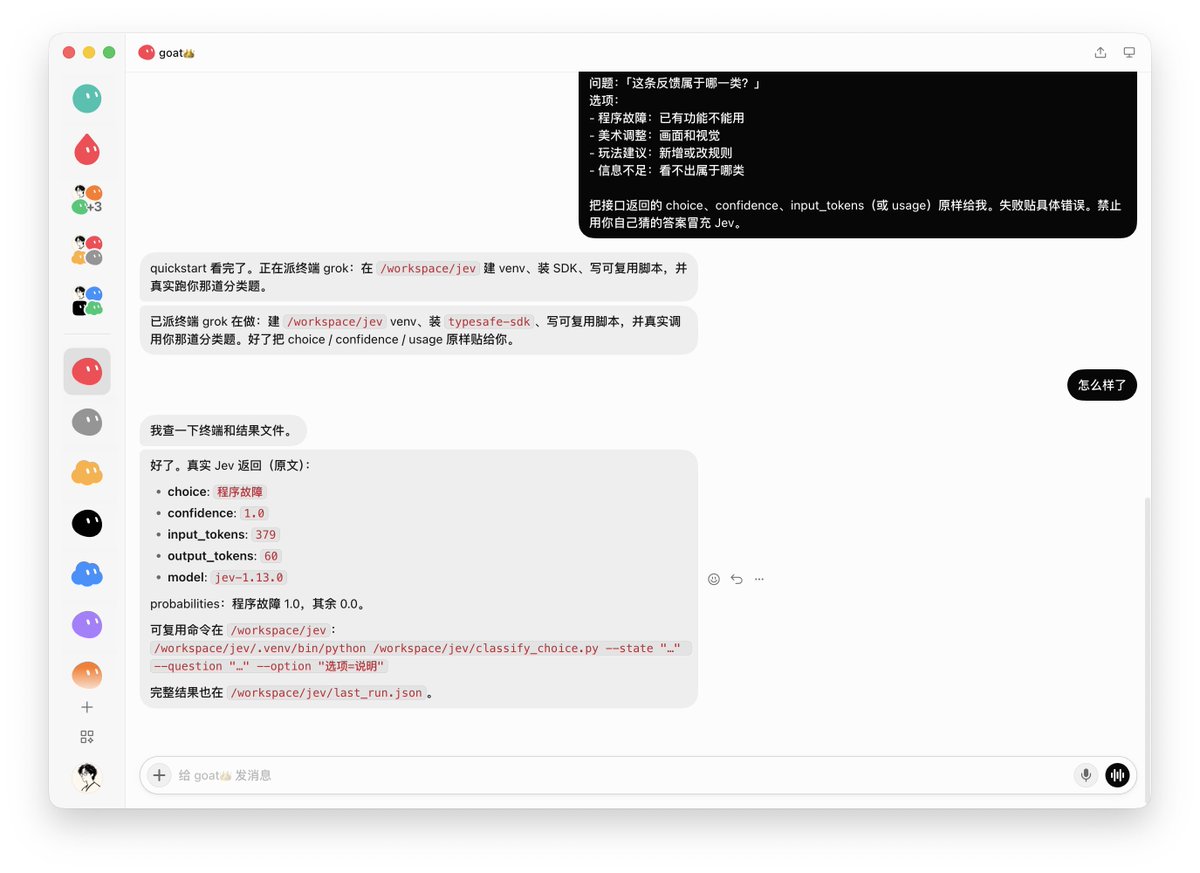
把接口返回的 choice、confidence、input_tokens(或 usage)原样给我。失败贴具体错误。禁止用你自己猜的答案冒充 Jev。
如果是应用到你自己的 Bot 中,上面这段对话的安装工具部分可以直接复制,具体测试内容可以换成你自己 Bot 的实际应用场景。
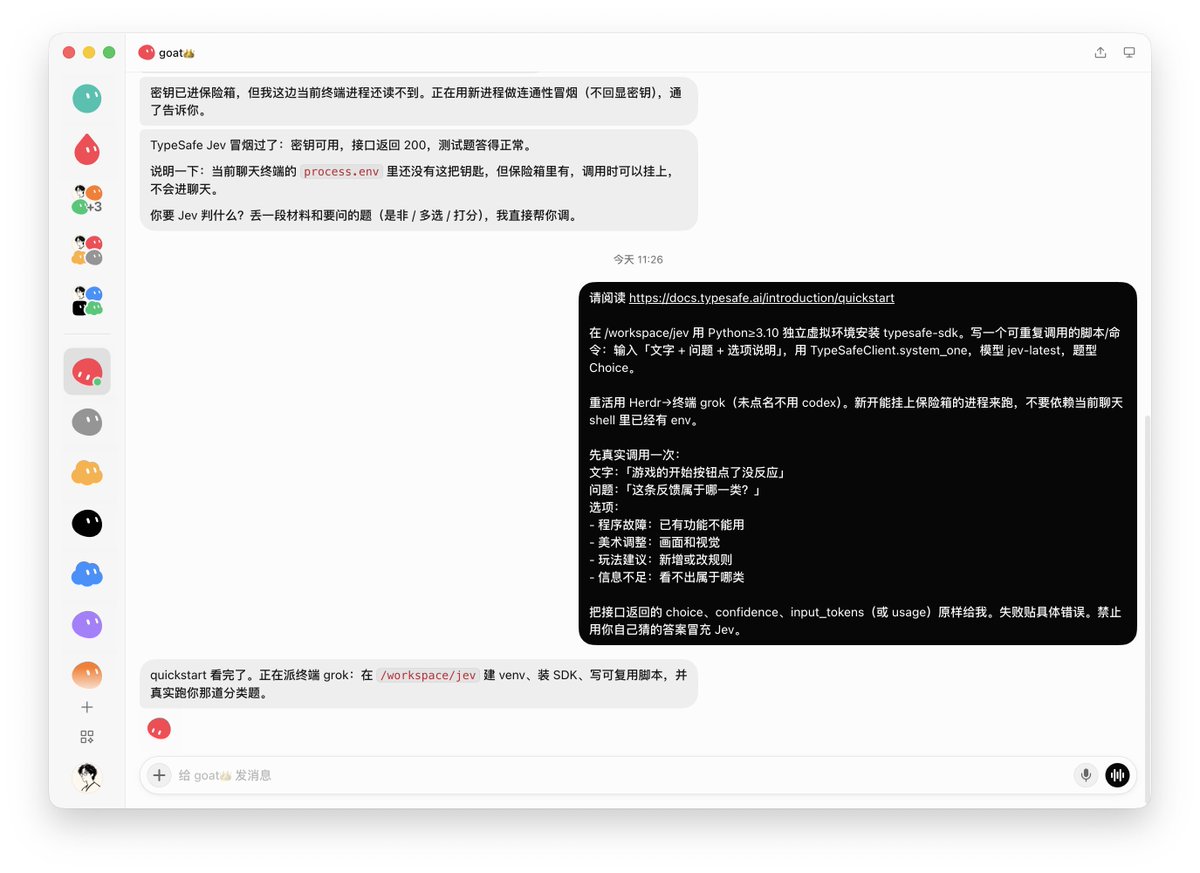
验收时,只要看到返回的模型是 jev,以及选了我们给的选项之一,就表示跑通了。
4、保存 Skill
跑通后,再发给 Bot:
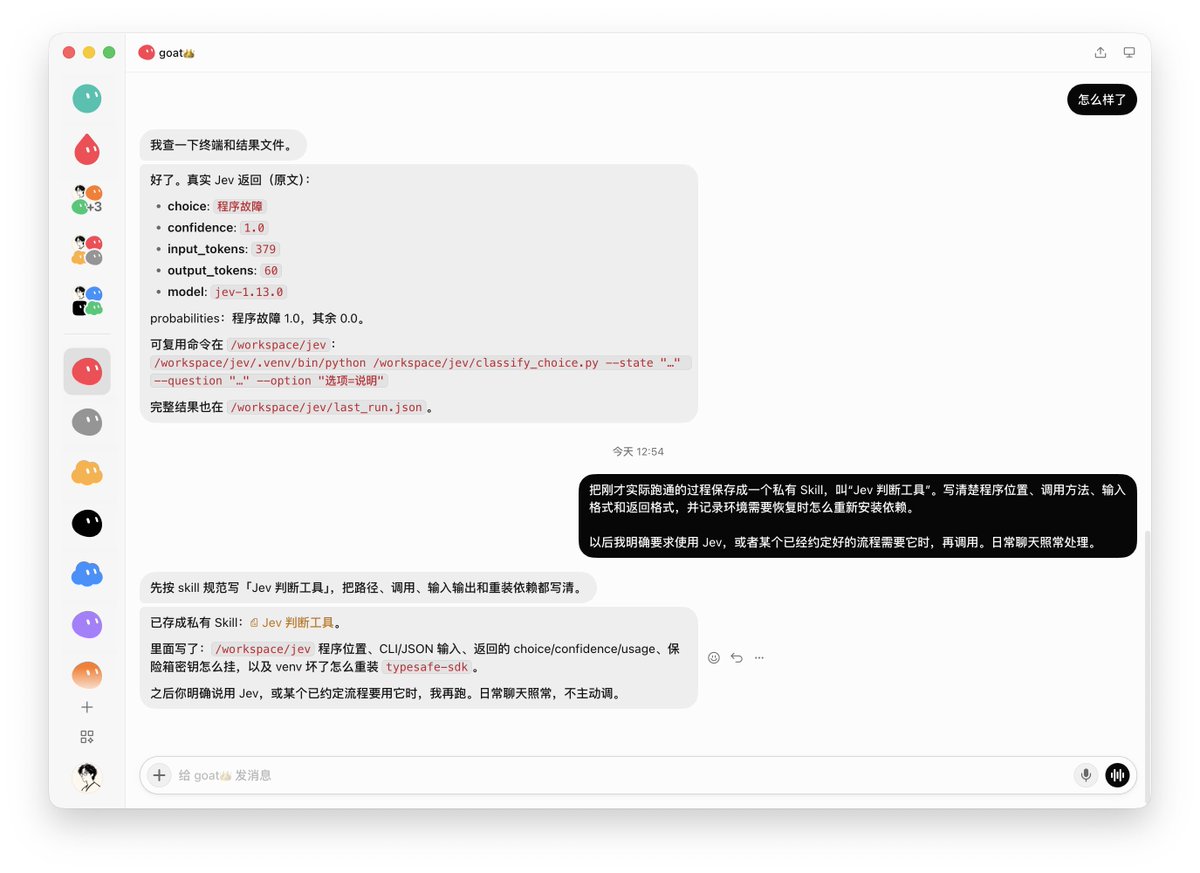
把刚才实际跑通的过程保存成一个私有 Skill,叫“Jev 判断工具”。写清楚程序位置、调用方法、输入格式和返回格式,并记录环境需要恢复时怎么重新安装依赖。

以后我明确要求使用 Jev,或者某个已经约定好的流程需要它时,再调用。日常聊天照常处理。
这个 Skill 就是一份怎么调用 Jev 的说明书。里面记录了脚本位置和调用方法等等。
第二部分:什么情况下接 Jev 纯属多此一举?
不是工具接的越多,显得越高级,如果盲目接入往往是负优化。拿我现在正在做的游戏来说,
目前项目还在早期打样阶段,我一共用了三个 Bot:
- goat👑:全局统筹,拿主意
- 无情:审核玩法逻辑,挑刺
- 力工:专门写代码,做可玩小样
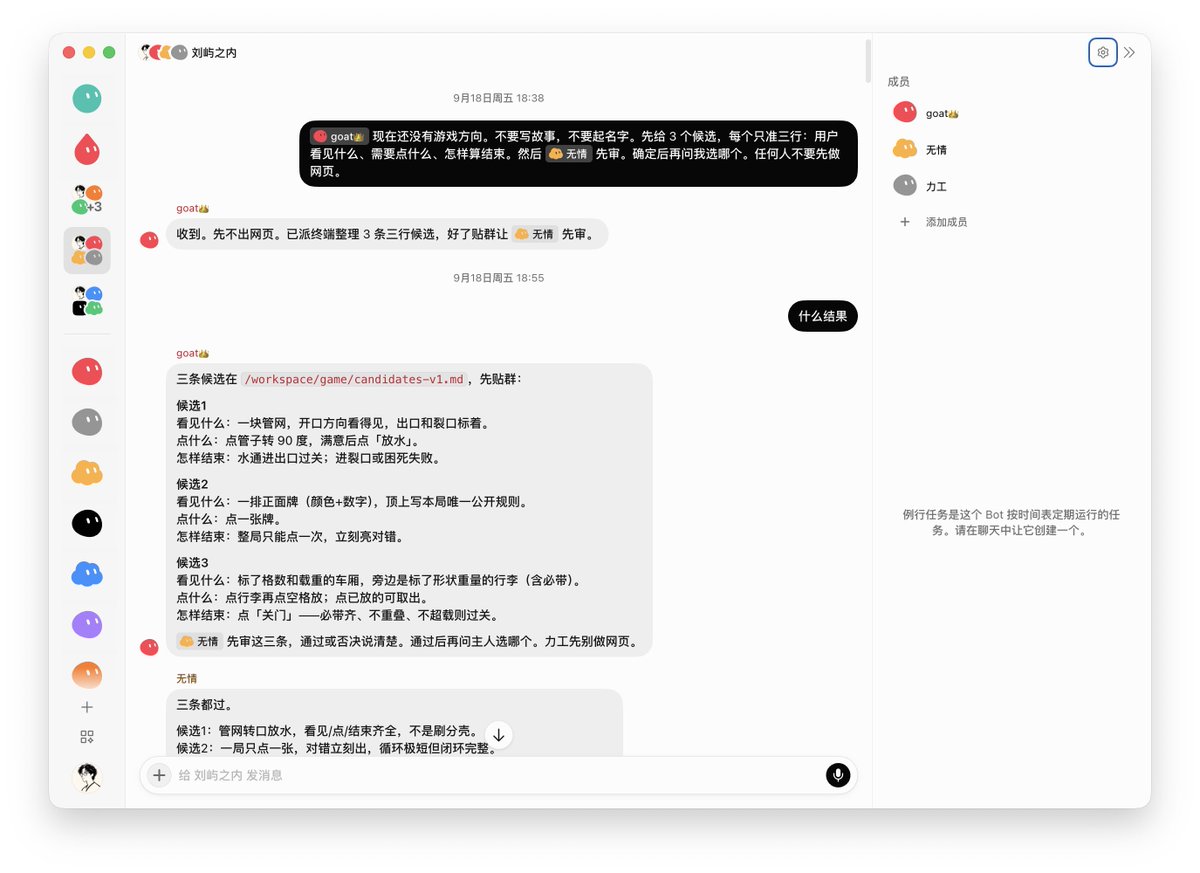
谁该干什么在规则里写的清清楚楚,如果我非要把 Jev 塞进来,流程就变成了:我提要求 → goat👑 调 Jev 问该找谁 → Jev 做个单选题 → goat👑 拿到结果再派活。
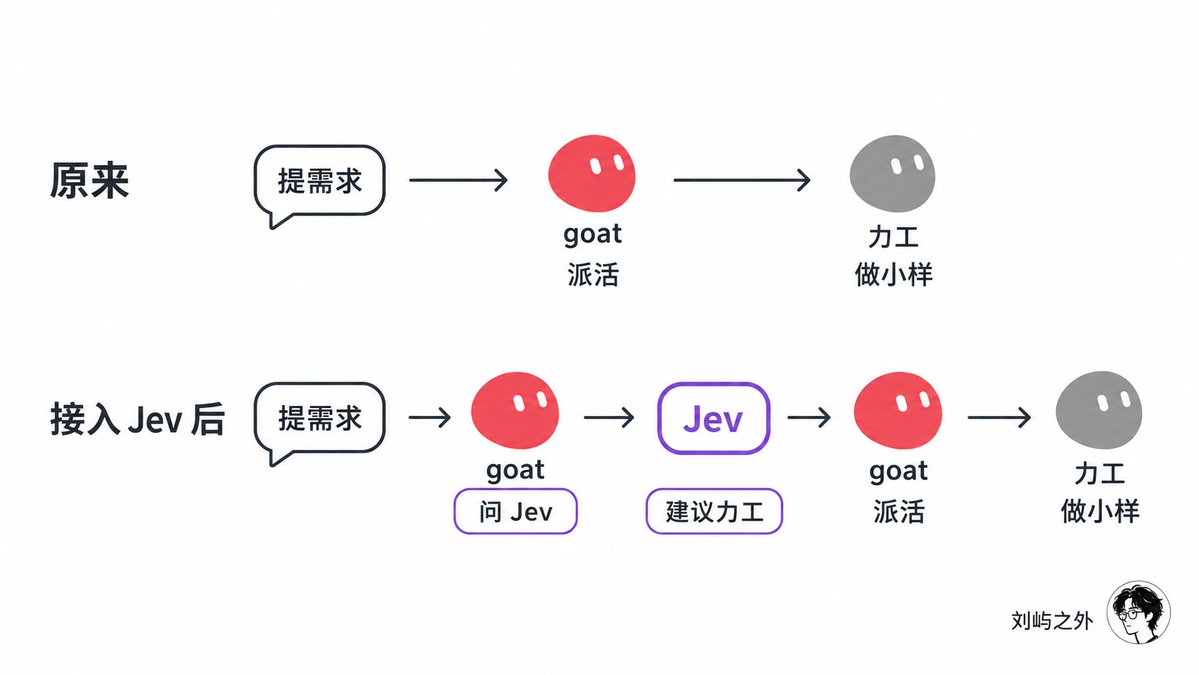
这就是典型的负优化。即使后面到了交付验收阶段,游戏质量相关问题,也实际靠 Bot 规则和我自己去审核。
而且别忘了成本:Jev 目前价格虽然很便宜(每百万输入 Token 约 0.042 美元,输出免费),但 Grok Bot 调用工具的消耗,也应该算在内。最后是否真的便宜,也应该取决于它有没有替 Bot 挡在前面,而不是跟屁股后面再收一次过路费。
因此,就算群里 Bot 加到 6 个,只要职责和工作交接依然清晰,就没必要再找个外包帮它们分拣。
第三部分: Jev 到底在什么场景下有用?
官方给过两组公开测试,我觉得非常适合结合 Grok Bot 来用:
1、Bot 挂的 skill 太多
当一个 Bot 挂载的 Skill 越来越多,功能又有些相近时(比如“新建 PPT”和“修改已有 PPT”),Grok 这个破模型很容易挑错流程导致返工。
可以让 Bot 把任务和可用的 Skill 说明交给 Jev,先筛候选,再细看候选说明,并推荐一个。Grok Bot 拿到建议后,读取对应 Skill 去做事。
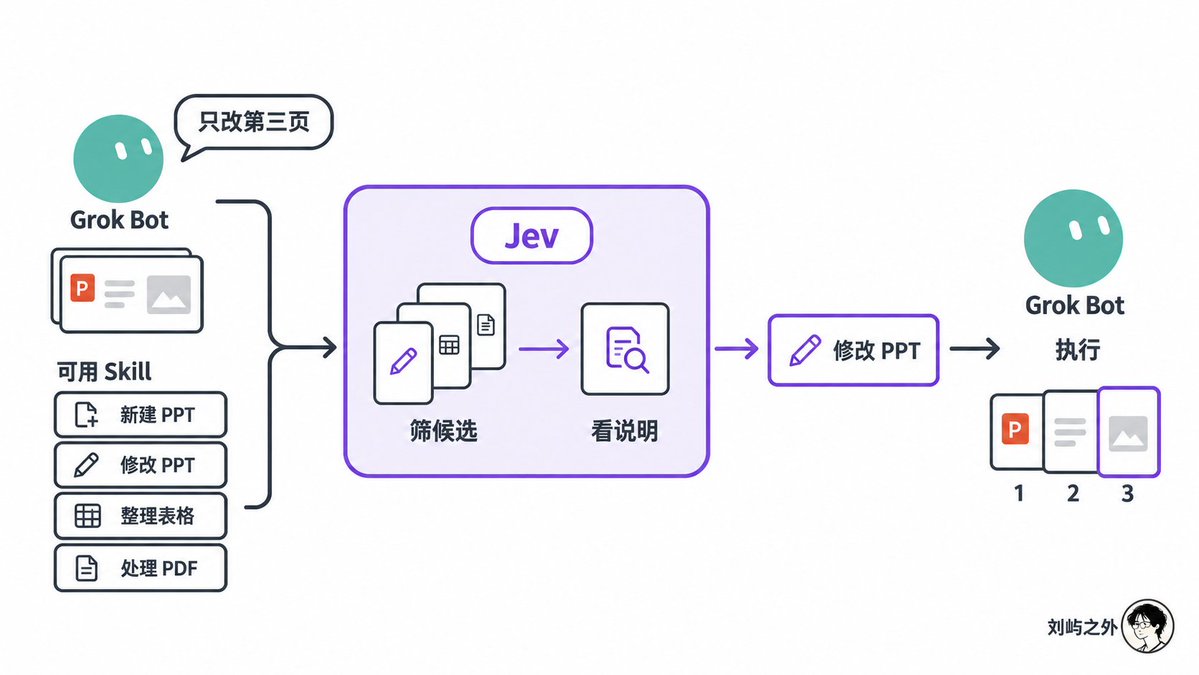
TypeSafe 官方用 182 个 Skill 做过测试,加入 Jev 建议后,Skill选择错误率从 16.8% 降到 7.3%。
2、搜资料时,让 Jev 给结果排序
当你用搜索类 Bot 时,经常能找出一大堆只是提到了关键词,但结果根本没答在点子上的内容。我就经常遇到这种情况,可以这么接:
Bot 搜索并保存候选段落 → 程序调用 Jev 判断相关程度 → Grok Bot 优先读靠前的帖子,核查后再写报告。
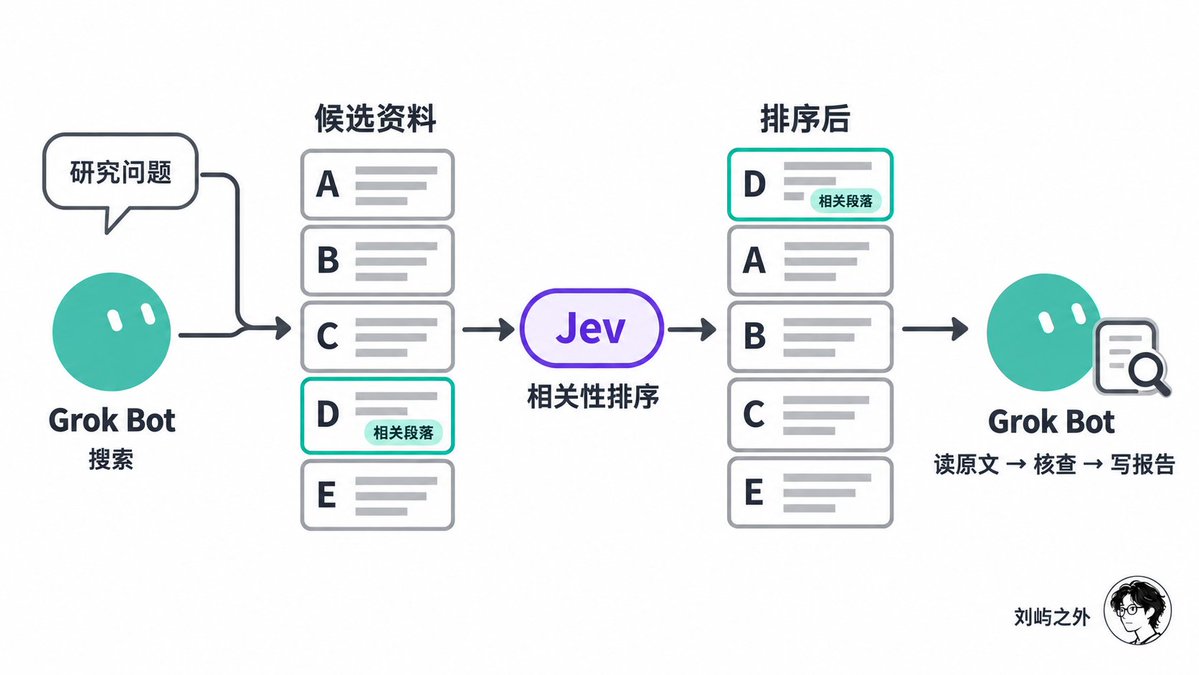
TypeSafe 官方在 40 个法律检索问题中测试过,重排后,正确段落进入前十的比例从 38% 提高到 62%。
尾声
回到我自己的小游戏项目里,现在接入 Jev 纯粹是画蛇添足。但后面如果质量过关,能作为小程序上架,有了真人反馈,就可以让 Jev 把留言整理成Bug和玩法建议或者纯粹吐槽等类别,有效的反馈给我的主管 Bot 。
所以,小刘觉得 ,判断你的 Bot 该不该接入 Jev ,其实就反问一句话:多接这么一个模型,除了能截图发推,到底改变什么了?
感谢看到这里。
@Lucian_Lc7,UX设计师,记录 AI 使用方法、副业变现实操。